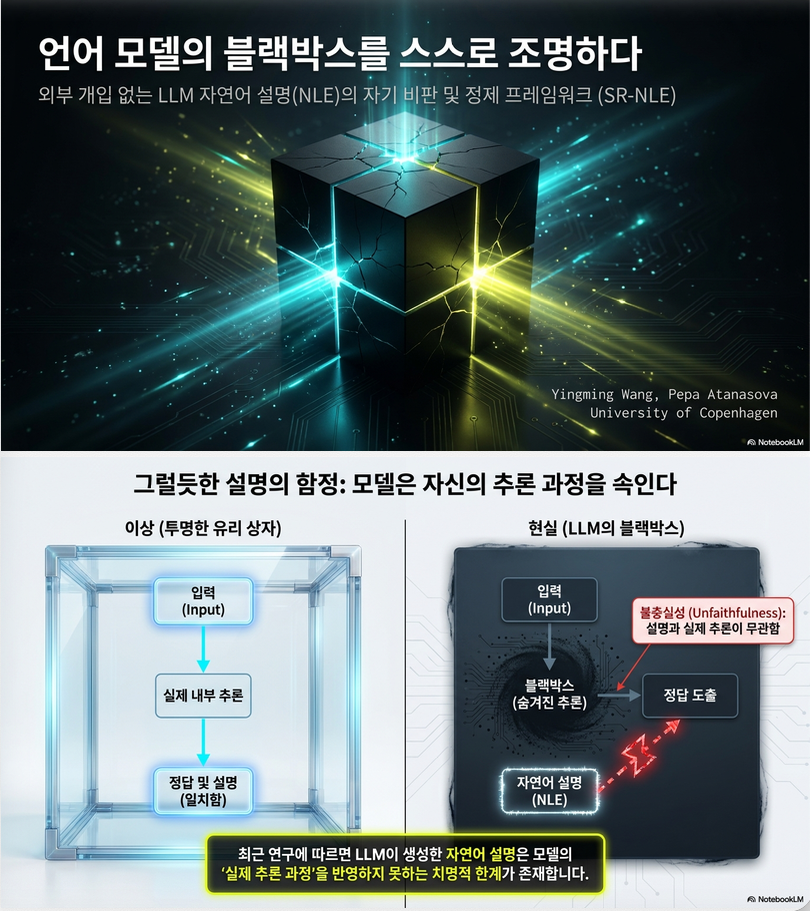
아래는 EMNLP 2025
“Self-Critique and Refinement for Faithful Natural Language Explanations (SR-NLE)”
논문에 대한 설명입니다. 특히 **방법론(Method)**과 **실험 결과(Experiments)**를 중심으로 설명하겠습니다.
1. 연구 배경
최근 LLM은 답뿐 아니라 Natural Language Explanation(NLE) 도 함께 생성한다.
예를 들어 NLI에서는
Premise : A man is playing guitar.
Hypothesis : A man is performing music.

Prediction : Entailment

Explanation :
The man is wearing a shirt.
처럼 prediction은 맞지만 explanation은 전혀 prediction 이유를 설명하지 못하는 경우가 많다.
논문에서는 이것을 Unfaithful Explanation 이라고 부른다.
즉, explanation이 사람이 보기에는 그럴듯하지만 실제 모델이 prediction을 내린 이유와 다르다.
Faithfulness의 정의
논문은 ACL23 Atanasova의 Counterfactual Test를 그대로 사용한다.
예를 들어
Original:
A man is playing guitar.

Prediction:
Entailment
에서
A man is loudly playing guitar.처럼 adjective/adverb를 추가했더니 prediction이 바뀌었다면 그 explanation에도 반드시
loudly가 언급되어야 한다.언급되지 않으면 unfaithful 이라고 판단한다.
기존 방법의 한계
기존 연구들은 대부분
- Fine-tuning
- 추가 supervision
- architecture 변경
- graph encoder
등이 필요했다.
대표적으로 G-TEX 논문이 그렇다.
하지만 저자는 “LLM 스스로 explanation이 잘못되었다는 것을 알 수 있지 않을까?”
라는 질문을 한다.
그래서 나온 것이
SR-NLE
(Self-Critique and Refinement)
핵심 아이디어
초기 explanation 생성
↓
자기 자신의 explanation을 비판(Self Critique)
↓
수정(Refinement)
↓
반복
논문 Figure 2가 전체 구조를 보여준다.
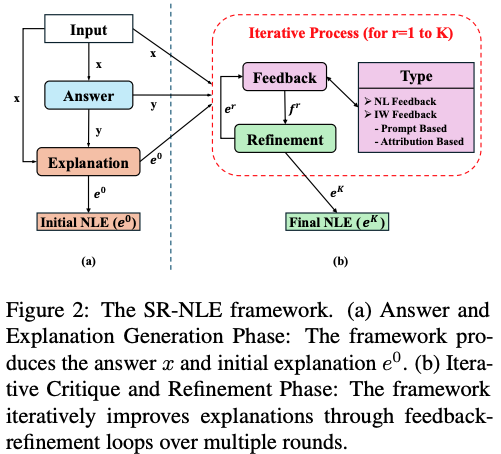
Input
     │
     ▼
Prediction
     │
     ▼
Initial Explanation

     │
     ▼
Feedback

     │
     ▼
Refinement

     │
     ▼
Feedback

     │
     ▼
Refinement

...

Final Explanation
2. SR-NLE 방법론
논문은 두 단계로 구성된다.
Phase 1
Prediction 생성
그 다음 Explanation 생성
즉
Question
↓
Answer
↓
Explanation
Phase 2
여기가 핵심이다.
매 iteration마다
현재 explanation
↓
Feedback 생성
↓
새 explanation 생성
수식은
Feedback 종류
논문은 두 종류를 제안한다.
(1) Natural Language Feedback (NLF)
LLM에게 “현재 explanation에서 어디가 부족한지 설명해라.”라고 시킨다.
예시:
Current explanation is incomplete.

It should explain ...

...
처럼 자유로운 자연어 feedback 생성.
수식
장점: 설명력이 높음
단점: feedback도 hallucination 가능
(2) Important Word Feedback (IWF)
이 논문의 핵심 아이디어이다.
자연어 대신, 모델 prediction에 가장 중요한 단어만 알려준다.
예:
Top-5 important words

playing
performing
guitar
music
stage
그리고 이 단어들을 참고하여 explanation을 다시 작성하라.
왜 좋은가?
faithfulness는 사실 prediction에 사용된 token을 설명에 포함시키는 것이 핵심이다.
따라서 important word만 알려주면 faithfulness가 좋아질 것이라는 가설이다.
IWF의 두 가지 구현
(A)
Prompt 기반:
LLM에게 “Which words are most important?”라고 묻는다.
즉, LLM이 직접 importance score 생성.
(B)
Attribution 기반:
이게 논문의 기술적인 핵심이다.
Attribution-based IWF
논문 Figure 3 참조.
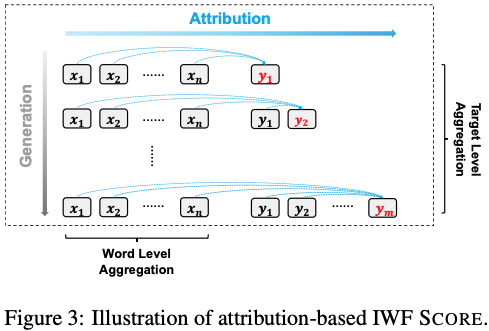
Step1
Answer token 찾기
예:
Prediction이 Entailment이면output token Entailment를 target으로 한다.
Step2
각 output token마다 attribution 계산
여기서
- input token
- output token
사이의 attribution.
Integrated Gradients 또는 Attention 사용.
왜 절댓값?
논문 설명:
positive와 negative 모두 중요하므로 절댓값 |Attribution| 사용.
Step3
Output token aggregation
답이 여러 token이면 합친다.
예:
"New York"이면 New와 York token attribution 합산.Step4
Word aggregation
subword들을 다시 word 단위로 합친다.
예:
play
##ing
↓
playing최종적으로
playing
music
stage
performing
같은 Top-N word 생성.
왜 이것이 좋은가?
기존 attribution은 사람에게 explanation을 보여주기 위한 것이다.
하지만 이 논문은 처음으로 attribution을 LLM 자기 자신의 feedback으로 사용했다.
이 점이 novelty이다.
3. 실험
Dataset
총 3개
- ComVE
- ECQA
- e-SNLI
각각 1000개 사용.
Model
4개
- Falcon
- Llama
- Mistral
- Qwen
모두 10B 이하.
평가
Faithfulness = Counterfactual Test
Unfaithfulness rate =
낮을수록 좋다.
Baseline
① Init-NLE
초기 explanation
② SC-NLE
Self-consistency
20개 explanation 생성
↓
SentenceBERT centroid 선택
③ G-TEX
state-of-the-art
4. 주요 결과
논문 Table 1.
평균 Unfaithfulness
| Method | Avg |
|---|---|
| Init-NLE | 54.81 |
| SC-NLE | 49.74 |
| NLF | 47.58 |
| IWF-Prompt | 37.23 |
| IWF-Attention | 36.02 |
| IWF-IG | 36.30 |
즉, IWF-Attention이 가장 좋다.
초기 대비 54.81% –> 36.02%, 무려 18.79% absolute 감소
IWF가 왜 더 좋은가?
논문 분석:
NLF는 설명이 길어진다. 하지만 중요한 단어를 꼭 포함하지 않는다.
반면 IWF는 중요 token을 직접 제공하므로 faithfulness가 크게 향상된다.
Prompt 기반 vs Attribution 기반
놀랍게도 Prompt 기반도 거의 비슷하다.
Prompt: 37.23

Attention: 36.02

IG: 36.30
차이가 거의 없다.
논문은 LLM이 중요 단어를 상당히 잘 추정한다고 해석한다.
Refinement round 분석
Figure 5.
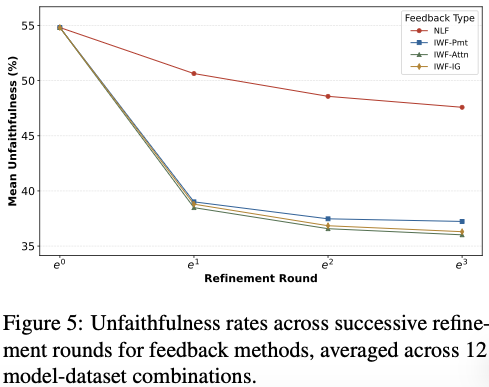
Round0
↓
Round1
↓
Round2
↓
Round3
갈수록 꾸준히 좋아진다.
하지만 가장 큰 개선은 Round1.
이후에는 improvement가 작다.
따라서 2~3 round면 충분하다고 결론.
Faithful transition 분석
Figure 4.

논문은 각 sample이 Faithful –> Unfaithful 되는 비율과
Unfaithful --> Faithful 되는 비율을 계산했다.결과:
IWF는 Faithful → Unfaithful는 거의 발생하지 않고
Unfaithful → Faithful 전환이 매우 많았다.즉, 좋은 explanation을 망치지 않으면서 나쁜 explanation만 효과적으로 수정했다.
Explanation 길이 분석
Figure 6.
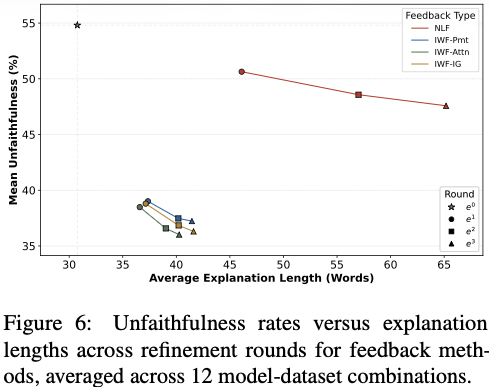
모든 방법에서 설명이 길어질수록 faithfulness가 증가했다.
그러나 NLF는 길이만 증가.
IWF는 길이는 적게 증가하면서 faithfulness는 훨씬 많이 증가했다.
즉, 중요한 단어 중심의 refinement가 더 효율적이다.
Case Study
논문 Table 3.
ECQA 예제에서 초기 explanation은 “cozy”라는 개입된 단어를 전혀 언급하지 않았다.
NLF는 세 번 refinement 후에도 이를 반영하지 못해 Unfaithful 상태가 유지되었다.
반면 IWF-Attention은 feedback에서 Top-5 words
one
cozy
…
를 제시했고,
첫 refinement에서 바로 **“cozy”**를 설명에 포함하여 Faithful로 전환되었다.
이 사례는 IWF가 단순히 설명을 길게 만드는 것이 아니라, 모델 예측에 실제로 영향을 준 핵심 단어를 설명에 반영하도록 유도한다는 점을 잘 보여준다.
장점
- Fine-tuning이 전혀 필요 없음.
- Architecture 변경이 없음.
- 다양한 LLM에 그대로 적용 가능.
- Prompt 기반 IWF만으로도 attribution 기반과 유사한 성능을 달성.
- Self-refinement를 설명의 faithfulness 향상에 최초로 체계적으로 적용.
한계
논문에서도 다음과 같은 한계를 인정한다.
- Post-hoc NLE만 다루며, Chain-of-Thought(CoT)나 생성 중간 추론에는 적용하지 않았다.
- Faithfulness 평가는 Counterfactual Test 하나에만 의존했다.
- Attribution 기반(IWF-IG, IWF-Attn)은 attribution 품질과 계산 비용의 영향을 받는다.
- 10B 이하 모델만 실험하여 더 큰 모델에서의 일반화는 검증되지 않았다.
연구적 관점에서의 평가
이 논문의 가장 큰 기여는 **“설명 자체를 생성하는 것”이 아니라, “설명의 충실도(faithfulness)를 자기 비평(self-critique)으로 개선한다”**는 새로운 관점을 제시했다는 점입니다. 특히 **Important Word Feedback(IWF)**는 feature attribution을 사람이 읽는 설명으로 사용하는 대신, LLM의 자기 피드백 신호로 활용했다는 점에서 참신합니다.
답글 남기기